中級者資料作成
GeneBench-Pro:ゲノム解析のAI性能を測定する新ベンチマーク
GeneBench-Proは、ゲノム解析・生物学研究における生成AIの性能を測定する新しいベンチマークツール。実世界のデータセットを用いて、医療・創薬分野でのAI活用を促進します。
約3分
読むOpenAIが新しい評価手法「Deployment Simulation」を発表しました。本番環境にリリースする前に、実際の会話データを使ってAIモデルの動作を予測し、安全性と評価精度を向上させる方法です。
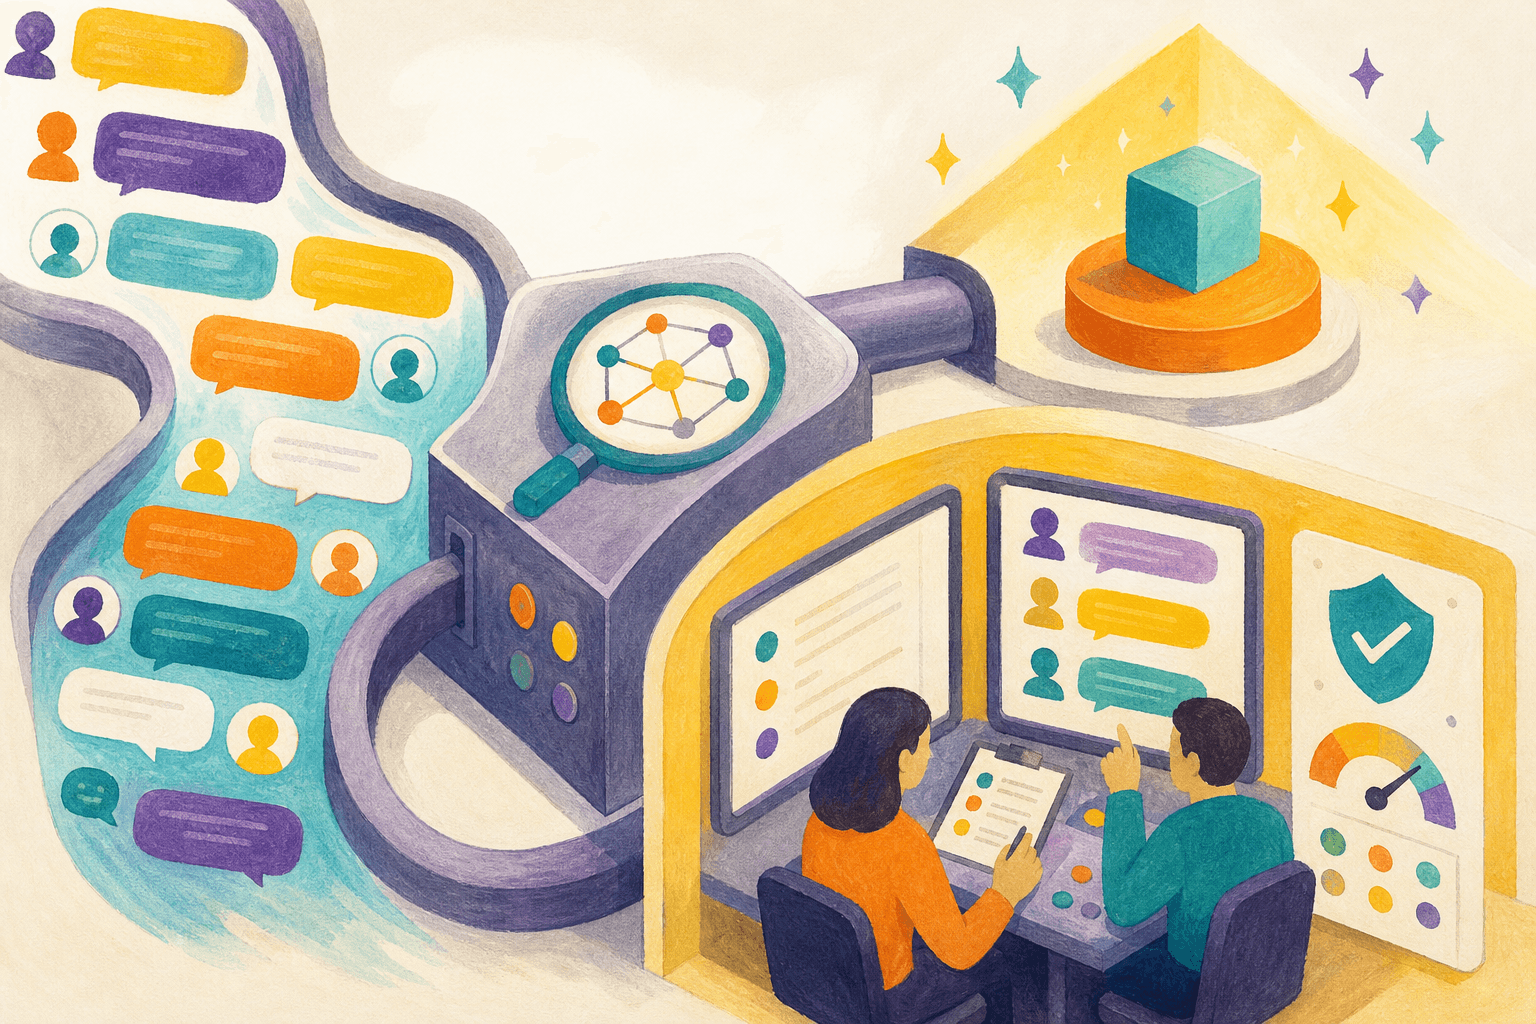
OpenAIが新たな評価手法「Deployment Simulation」を発表しました。この手法は、AIモデルを実際の本番環境にリリースする前に、実現象に近い会話データを用いてモデルの動作を予測し、安全性と評価精度を向上させるものです。本記事では、この新しい検証方法がなぜ重要なのか、どのような仕組みなのかを解説します。
Deployment Simulationは、AIモデルを本番環境にリリースする前に、実際のユーザーとの会話パターンに基づいてモデルの動作をシミュレーションする評価手法です。
従来のAI開発では、開発環境での評価と本番環境での実際の動作にズレが生じることがありました。Deployment Simulationは、この「ギャップ」を埋めるために、リアルな会話データを活用して事前に予測精度を高めます。
開発チームがこの手法を活用する主な場面は以下の通りです:
新機能のリリース前評価
モデルの大規模更新時
多言語・多地域への展開前
コンテンツポリシー遵守の確認
この手法を用いた検証プロセスの流れは以下のようなものです:
| ステップ | 内容 |
|---|---|
| 1. データ収集 | 実際のユーザー会話から無作為にサンプルを抽出 |
| 2. シミュレーション実行 | 新モデルで該当の会話を再実行 |
| 3. 動作評価 | 出力の正確性・安全性・関連性を多角的に分析 |
| 4. 問題の特定 | 改善が必要な領域を特定 |
| 5. 改善・再検証 | 問題を修正し、シミュレーションを再実行 |
AIモデルが社会的に大きな影響を持つようになる中で、本番環境へのリリース前の検証は開発企業の責任です。Deployment Simulationのような手法は:
A:完全な予測はできません。本番環境では常に予期しない使い方や状況が存在します。ただし、多くの潜在的な問題を事前に検出し、リリース後のリスクを大幅に軽減できます。
A:多くのAI開発企業が類似の検証手法を採用していますが、Deployment SimulationはOpenAIが公開した具体的な方法論として注目されています。業界標準化に向けた一歩といえます。
A:基本的な考え方は汎用的ですが、OpenAIの具体的な実装方法がどの程度公開されているか、また自社データへの適用可能性は別途検討が必要です。
A:はい。AI技術の信頼性向上は国内外を問わず重要であり、本番前の適切な検証は法的規制やユーザー信頼の観点からも必須となっていきます。
GeneBench-Proは、ゲノム解析・生物学研究における生成AIの性能を測定する新しいベンチマークツール。実世界のデータセットを用いて、医療・創薬分野でのAI活用を促進します。
OpenAIが発表した教育向けの新プラグインが、K-12から大学まで、教員と学生の学習・指導を革新します。ChatGPT WorkとCodexの活用方法を解説。
OpenAIが発表した新しい分析フレームワークは、米国の921職種と1億4800万人の労働者を対象にAI導入の影響を4つのカテゴリーに分類。自動化リスク、業務再編、成長機会、影響最小限の職種を特定する仕組みを解説します。