中級者資料作成
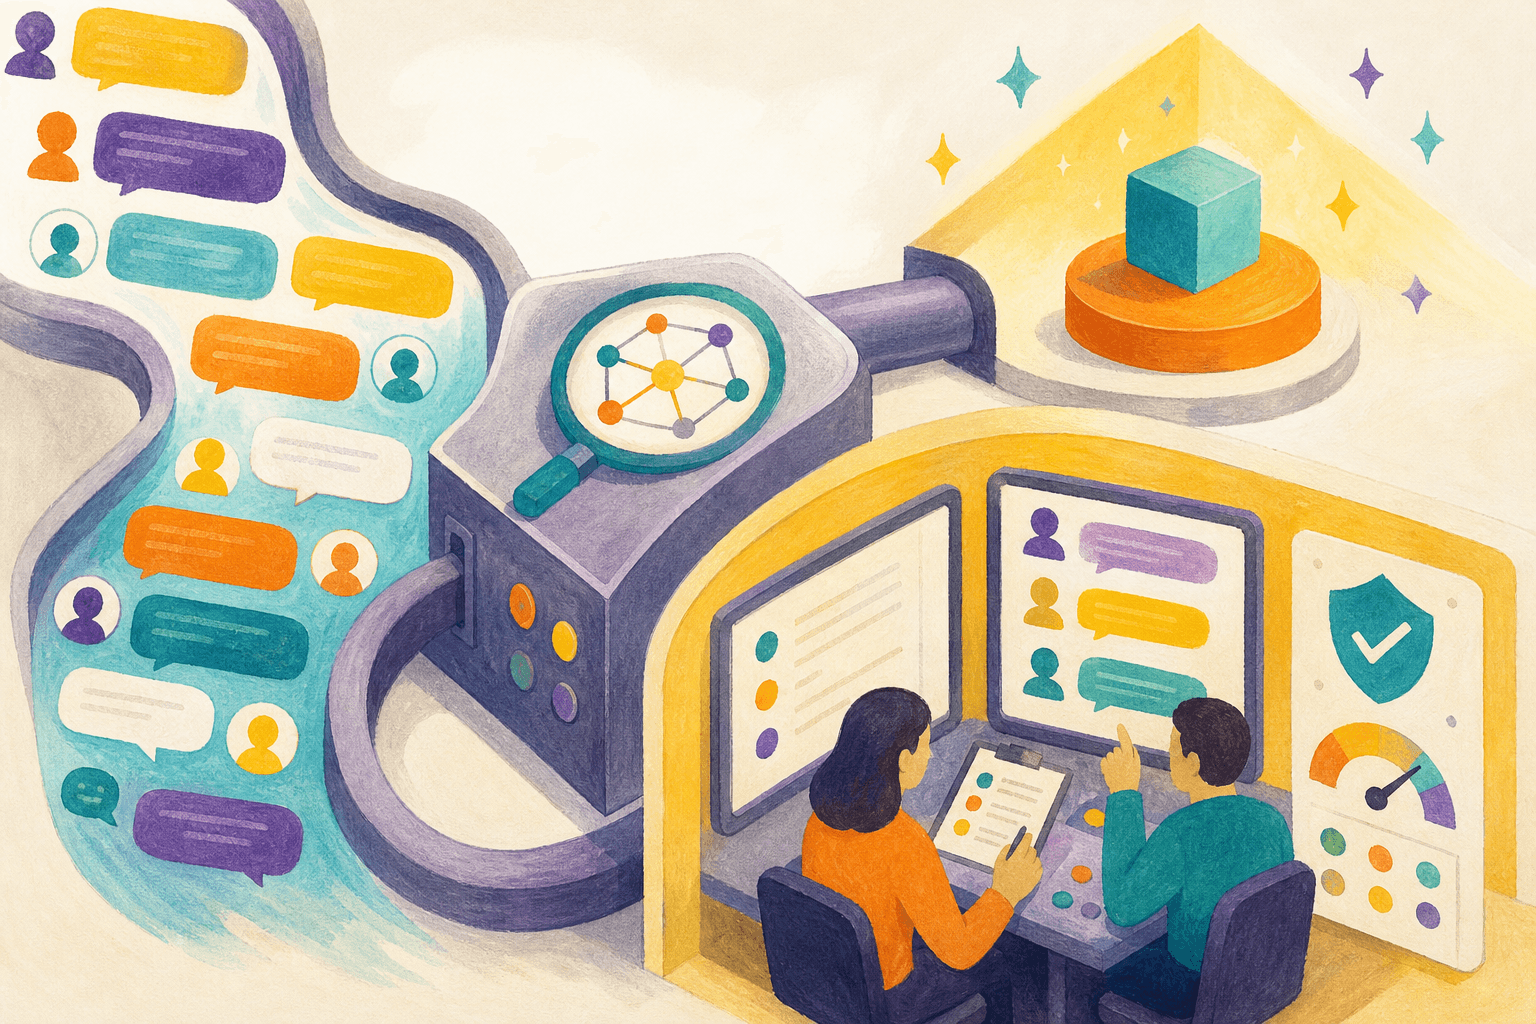
OpenAIが「Deployment Simulation」でAIモデルの動作を事前検証
OpenAIが新しい評価手法「Deployment Simulation」を発表しました。本番環境にリリースする前に、実際の会話データを使ってAIモデルの動作を予測し、安全性と評価精度を向上させる方法です。
約5分
読むGeneBench-Proは、ゲノム解析・生物学研究における生成AIの性能を測定する新しいベンチマークツール。実世界のデータセットを用いて、医療・創薬分野でのAI活用を促進します。
GeneBench-Proは、ゲノム解析・生物学研究分野における生成AIの性能を測定するための新しいベンチマークツールです。複雑で実世界のデータセットを用い、AIモデルがゲノム解析や科学研究の実務でどの程度の精度を発揮できるかを客観的に評価します。
AI技術が医療・創薬分野での活用を期待される一方で、実際の科学研究環境でのAI性能を正確に測定する評価基準が不足していました。GeneBench-Proは、こうしたニーズに応える形で、実際の研究データを反映したベンチマークを提供します。
| 項目 | 説明 |
|---|---|
| 評価対象 | ゲノム解析、生物学研究、科学データ分析 |
| データセット | 複雑・実世界型 |
| 用途 | AIモデルの性能比較・検証 |
| 導入効果 | 医療・創薬分野での実用化判断に活用可能 |
GeneBench-Proの提供により、以下のような利点が期待されます:
具体的な利用条件や提供対象については、公式な発表資料の確認をお勧めします。研究機関や企業が段階的にアクセス可能になる場合も想定されます。
ベンチマークの詳細な実施方法や結果の公開予定については、OpenAIの公式情報を参照してください。
GeneBench-Proは実世界型データセットに特化し、複雑な科学データでのAI性能測定を重視する設計となっています。従来のベンチマークより医療実装に近い条件での評価が可能です。
OpenAIが新しい評価手法「Deployment Simulation」を発表しました。本番環境にリリースする前に、実際の会話データを使ってAIモデルの動作を予測し、安全性と評価精度を向上させる方法です。
OpenAIが発表した教育向けの新プラグインが、K-12から大学まで、教員と学生の学習・指導を革新します。ChatGPT WorkとCodexの活用方法を解説。
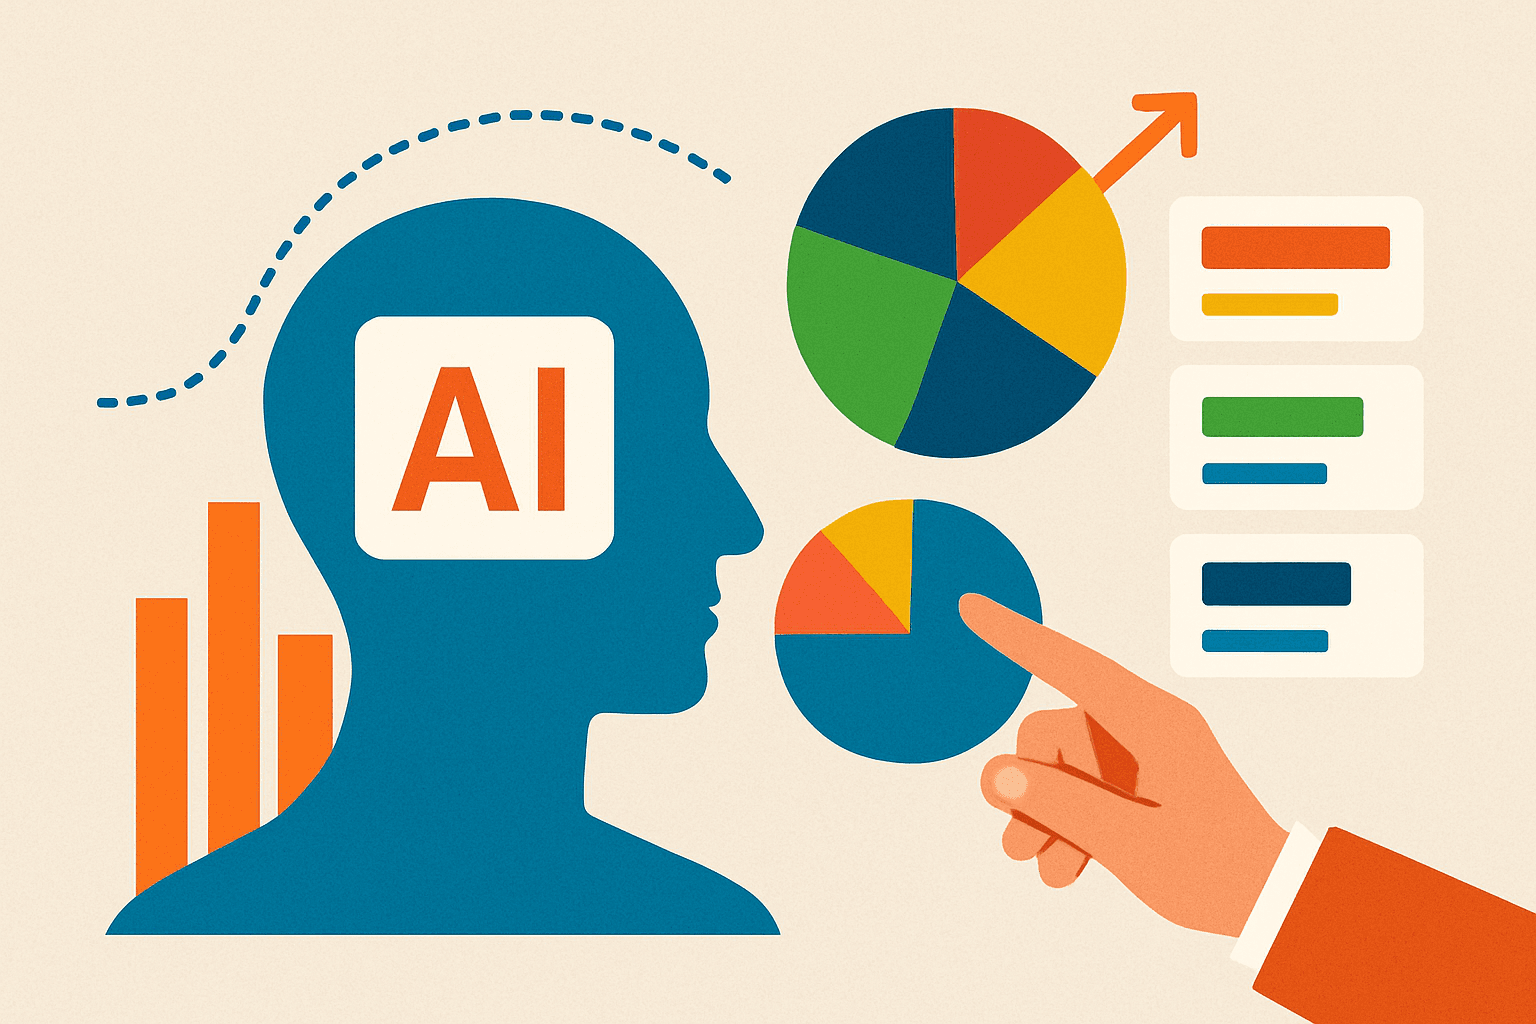
OpenAIが発表した新しい分析フレームワークは、米国の921職種と1億4800万人の労働者を対象にAI導入の影響を4つのカテゴリーに分類。自動化リスク、業務再編、成長機会、影響最小限の職種を特定する仕組みを解説します。